
这篇指南聚焦“Muse Voice Transcribe API”。下面把问题拆成容易跟做和复查的步骤。
01|这篇讲的是文件 API
Meta Model API 目前把 Muse Voice Transcribe 作为语音转文字模型提供。已有录音走 POST /v1/asr/transcribe;实时麦克风则走 WebSocket。下面只试一次文件上传,和 Mac 上按住 Fn 的日常听写分开。
Kalen Jordan 在 10 月 1 日发帖称,他觉得转写更准、更快、成本更低。这是他的个人体验,帖子没有提供可复算的样本、模型对照和计价明细。先别把这些比较当成普遍结论。我们只核对一个自己有权使用的短录音能否按官方格式返回文字。
02|先挑一段没有隐私的练习音频
准备一段 10 到 30 秒、内容你自己录制或获准处理的声音。可以读一小段虚构句子,里面带一个普通姓名、日期、金额和产品词,便于之后逐项检查。不要拿会议录音、客户通话、家人声音、账号口令或真实个人资料做第一轮测试。
先记下原文件名、时长、语言和你实际说出的词。最好同时写一份人工听写的参考稿。这样请求完成后可以对着原音逐字回听,区分语音识别错误和自己记错。测试音频短一些,也容易控制上传大小和可能产生的费用。
03|把音频转成接口接受的 WAV
官方文件接口接受 RIFF/WAVE 容器,内部是单声道、16 位整数 PCM,采样率为 16 kHz 或 24 kHz。MP3、M4A 或立体声 WAV 先转换,再上传。Meta 的示例用 ffmpeg 生成 24 kHz 文件,并去掉媒体元数据。示例命令如下。
ffmpeg -i input.m4a -ac 1 -ar 24000 -c:a pcm_s16le -map_metadata -1 sample.wav
转换后查看 sample.wav 的播放时长,并用播放器听开头、中间和结尾,确认声音没有被截断或变速。接口限制单段最多 10 分钟、整个请求体不超过 32 MB;第一次用短样本就能避开这两个边界。
04|先把 API 密钥放在本地安全位置
Meta 的官方快速入门要求在 Model API dashboard 创建 API key,再通过 HTTP Authorization Bearer 头发送。如果当前账户不能创建密钥,就先停在这里,不要换用来源不明的凭据。把密钥放在本机的环境变量或密钥管理器里,别写进脚本、仓库、截图、聊天提示词或公开日志。共享电脑和 CI 任务也要使用自己的受限凭据管理方式。
请求文件会离开本机并传给 Meta 的 API。上传前确认录音确实适合交给这个服务处理,并遵守录音参与者的同意、组织规定和保存期限。不要为了图省事把整段私人会议发上去;本教程只需要一段短而无敏感信息的自有录音。
05|先发一次最小请求
单段语音选默认的 PUSH_TO_TALK 模式即可,它把整个上传文件当成一段话。下面使用官方文档示例中的模型 ID;模型目录或你的账户若显示不同,以当前页面为准。JSON 响应会给出 transcript、audioDurationMs 和 turns,单段模式的 turns 为空。
可以用这条命令做一次请求。先把 MODEL_API_KEY 配置在本地环境里,再将文件名改为你实际转换好的 WAV。
在 Bash 或兼容 POSIX shell 的终端中,先设好本机 MODEL_API_KEY,再运行这条参考命令。Windows PowerShell 的变量和参数写法不同,不要原样粘贴。密钥只由终端变量带入,不要写进 Muse 对话或截图。
curl --fail-with-body -X POST "https://api.meta.ai/v1/asr/transcribe" -H "Authorization: Bearer $MODEL_API_KEY" -H "Accept: application/json" -F 'request={"model":"muse-voice-transcribe-1.0","audioEncoding":"WAV","mode":"PUSH_TO_TALK"};type=application/json' -F "[email protected];type=audio/wav"
这是一条参考请求,不是本站执行结果。拿到响应后保存 HTTP 状态码、返回的 sessionId、时长和错误信息,密钥不要和这些调试记录放在一起。
06|中英混说和专有词要单独抽查
官方说明列出 25 种可用语言并支持代码切换。languageBias 可以填写预期语言名称,例如 Mandarin Chinese 和 English;它只是提示,不会强制输出某种语言。keywords 可放少量产品名、地点或缩写,帮助模型留意这些词,但官方也明确说它不能保证拼写一定准确。
要测这两项,可以保持音频不变,再各发一遍请求,只增加 languageBias 或 keywords 中的一项。每次都记录改了什么,别同时改音频、模式和提示词。回听人名、金额、日期、英文缩写及否定词;把遗漏、替换和标点错误记下来,不用一个“看起来顺”的句子代替原声。
07|多人片段看分段,不把标签当身份
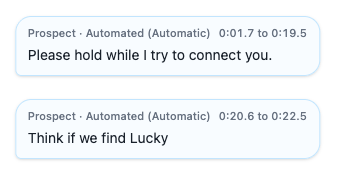
需要区分说话轮次时,可尝试 ENDPOINTING;需要模型附带 A、B 一类说话者标签时才看 DIARIZATION。响应里的 startMs 和 endMs 记录模型检测到语音起止时处理到的音频位置,适合回听定位,不是精确声学边界,也不是逐字时间戳。A、B 只是这份转写里的标签,不能验证真实身份。
先挑一段你获准处理、说话轮次清楚的音频,再核对每个片段的起止位置和对应原声。多人重叠、很短的插话或环境噪声容易让边界和标签不稳定。若你的工作只需要全文文字,就先用单段模式,避免引入暂时用不到的分段字段。
08|把文字、时间和说话标签分开核对
完整文字在 transcript 字段。选择 ENDPOINTING 或 DIARIZATION 后,响应还会带 turns。每个片段有转写、起止毫秒值和轮次编号;只有 DIARIZATION 才会附带 A、B 这样的 speaker 标签。
这些毫秒值反映模型检测到起止时已经处理到的音频位置,Meta 的 schema 明确说明它们不是精确声学边界。把它们当作回听原声附近的参考点。如果下游需要逐字字幕或法律记录,就不能把轮次时间戳当成逐词对应结果。
09|检查失败和真实用量后再扩大
HTTP 400 常见于音频不是要求的 WAV、格式参数错误或超过 10 分钟;413 表示请求超过 32 MB;406 是 Accept 格式不受支持;429 表示达到并发或小时会话限制,官方建议退避后重试;500 表示处理失败或超出服务预算。一次改一个问题,保留 sessionId;不要对同一错误快速循环重试。
完成后对照人工参考稿核对词、数字和时长,再查看 Model API dashboard 的 usage 与当前 pricing 页面。Meta 公开文档当前列有按处理音频时长计费和免费额度说明,具体价格、配额和账单以请求当天你的账户页面为准。单个短样本只能确认请求路径和返回结构,不能证明速度、准确度或成本优于其他服务。
需要普通桌面输入时,可继续看 Muse Mac 听写教程。这篇 API 示例适合开发者在自己的程序里核对文件转写。
参考来源
以下资料用于核对本文中的产品信息。Musevip 为独立中文指南,与 Meta 无隶属关系。
本文最后核验于 2026.10.02。产品页面可能更新。